「我辦公室就有 Mac,可不可以直接拿來跑公司的 AI?不想弄一個機房。」
這個想法其實很實際。很多老闆不想在辦公室放一台吵雜又耗電的伺服器,也不想為了 AI 去租機房。Mac 安靜、好看、插上電就能用,聽起來很理想。
我是熊董,台灣川輝科技創辦人。我帶團隊做系統導入七年,經手超過 252 個案子、橫跨 32 個以上產業,也在不同硬體上部署過地端模型。
我的答案是:可以,而且 Mac 在「放得下大模型」這件事上很有優勢。但它適合老闆或少數人自己用,不適合全公司同時用;文件很長、很多人一起問的時候,還是 NVIDIA 顯卡比較合適。
為什麼 Mac 放得下大模型?
一般電腦的顯卡有自己的記憶體,跟主機記憶體是分開的。消費級顯卡最多 32 GB,大模型常常放不下。
Apple 的晶片用的是「統一記憶體」,CPU 和 GPU 共用同一塊。所以只要記憶體夠大,模型就放得進去。依 Apple 官方規格,Mac Studio M5 Ultra 可以選 256 GB 或 512 GB,記憶體頻寬 1.2 TB/s。
這是很大的數字。依 VDF 的整理,256 GB 的 M5 Ultra 放得下 DeepSeek V4-Flash 的 4 位元版本;96 GB 版本就放得下 gpt-oss-120b。這些模型要用一般顯卡跑,通常要好幾張資料中心等級的卡。
Mac Studio 要多少錢?
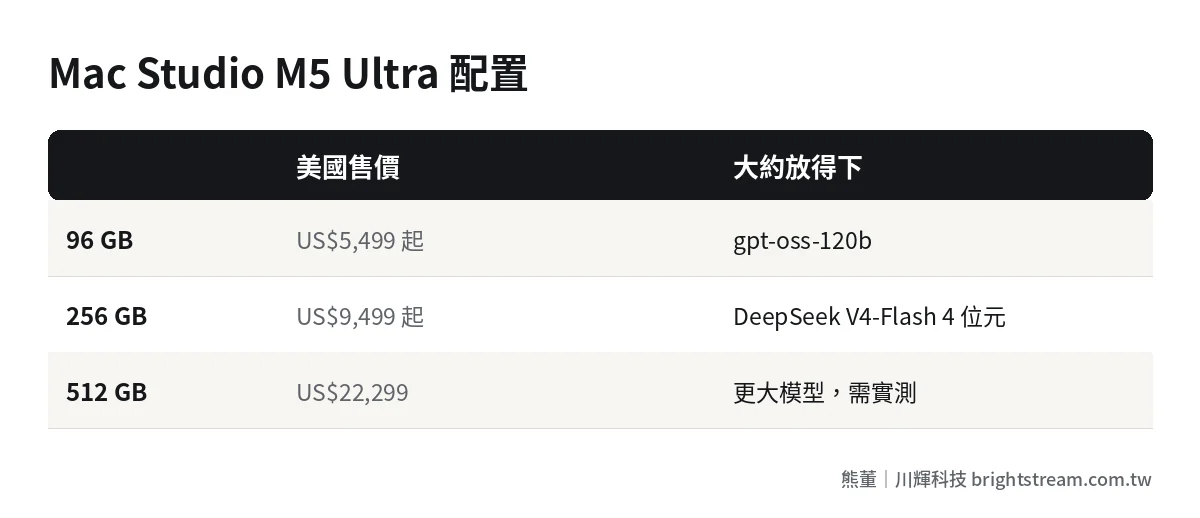
依 VDF 2026 年 11 月的整理,美國售價如下:
| 配置 | 美國售價 | 大約放得下 |
|---|---|---|
| M5 Ultra 96 GB | US$5,499 起 | gpt-oss-120b |
| M5 Ultra 256 GB | US$9,499 起 | DeepSeek V4-Flash 4 位元、Qwen3.8-Flash-Next 4 位元 |
| M5 Ultra 512 GB | US$22,299 | 更大的模型,但要注意實際可用空間 |
台灣售價這次沒有查到可引用的來源,以官方或經銷商當時的報價為準。512 GB 版本能不能放下特定模型,不同來源的算法不一樣:有人把系統可用記憶體調高後勉強放得下,有人只算八成可用空間就說放不下。實際要用的模型,最好先實測。
和其他硬體的比較,可以看地端 AI 要買什麼硬體。
Mac 跑起來有多快?
先講一個人用的情況。依 VDF 轉引 MacStories 的測試,M5 Ultra 跑 Qwen3.8-27B(4 位元),每秒產生 48 個 token,RTX 5090 是 59 個。差距不大,而且每秒 48 個已經比人閱讀快。
但讀題目的速度差很多:同一測試裡,M5 Ultra 每秒讀 1,701 個 token,RTX 5090 是 3,031 個。這代表文件越長,Mac 第一個字出現要等越久。同一來源提到,讀一份很長的文件,M5 Ultra 要 104 秒,比上一代 M3 Ultra 的 246 秒快很多,但還是比 NVIDIA 慢。
Mac 最大的限制:不適合多人同時用
這是決定 Mac 適不適合的關鍵。
依 Pinggy 的整理,Mac 上主要用的 MLX 框架沒有像 vLLM 那樣的多人批次處理;同一篇也指出,參數超過約 1,200 億的密集模型在 Mac 上就不太實用。換句話說,Mac 很適合一個人問一個大模型,但不適合十幾個人同時問。
多人同時用為什麼需要特別的引擎,我在地端 AI 跑多快那篇用實測數據說明過。簡單講:一個人快,不代表全公司快。
誰適合用 Mac 跑地端 AI?
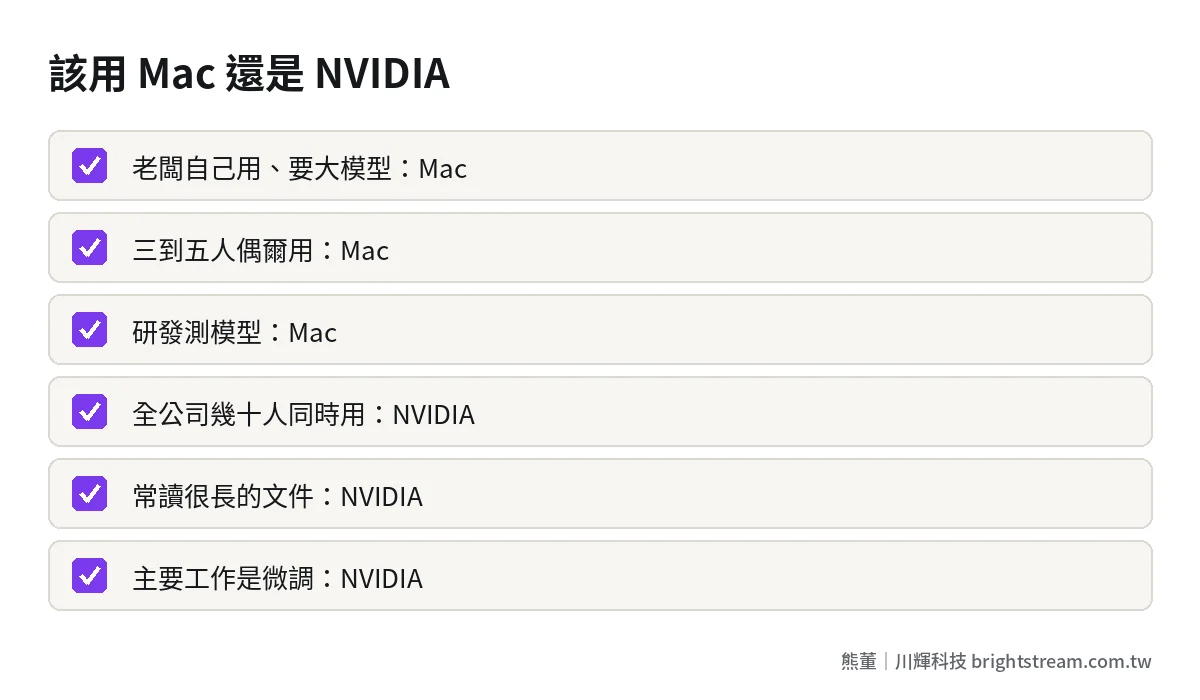
| 情況 | 適不適合 Mac |
|---|---|
| 老闆自己用,資料敏感、想要大模型 | 很適合 |
| 三到五人的小團隊,偶爾使用 | 適合 |
| 研發人員測試不同模型 | 很適合 |
| 辦公室不想放伺服器、怕吵怕熱 | 適合 |
| 全公司幾十人同時用 | 不適合,改用 NVIDIA 專業卡 |
| 每次都要讀很長的文件 | 不太適合,NVIDIA 較快 |
| 要微調模型 | 可以做,但 NVIDIA 工具較完整 |
我們常給的建議是:Mac 當老闆或研發的「個人 AI 工作站」,全公司共用的服務放在 NVIDIA 專業卡工作站上。兩者不衝突,可以一起用。
在 Mac 上要用什麼軟體?
Mac 上跑地端模型的工具已經很成熟。依 VDF 的整理,以下幾個都已支援 M5 Ultra:
- MLX:Apple 自己的機器學習框架(GitHub),在 Mac 上通常最快。不過它內建的伺服器不建議拿來做正式服務。
- LM Studio:有圖形介面,適合不想打指令的人,可以載入 GGUF 和 MLX 格式。
- Ollama:在 Apple 晶片上預設使用 MLX,安裝最簡單。要注意它本機的 API 預設沒有身分驗證,放在公司網路上要另外加保護。
- llama.cpp:對 Mac 的支援很完整,彈性大。
用 Mac 跑公司 AI 要注意的事
最後提醒三件事。
第一,安全設定不能省。 Mac 放在辦公室,很容易被當成「個人電腦」,忘了它其實在處理公司的敏感資料。要設帳號權限、限制對外連線,而且像 Ollama 這類本機 API 預設沒有驗證,不能直接開放給整個網路。
第二,要有備份。 模型檔案、知識庫、設定,都要定期備份。Mac 壞了,AI 服務就停了。
第三,還是要接進工作流程。 Mac 上跑的 AI,最好也接進員工每天用的系統或 LINE,而不是只有老闆打開某個軟體才用得到。這部分可以參考公司系統做在 LINE 裡。
常見問題
MacBook 也可以跑地端 AI 嗎?
可以跑中小型模型,例如 200 億參數左右的模型,適合個人試用。但筆電的記憶體和散熱有限,長時間跑大模型不理想,公司用途建議用 Mac Studio。
Mac Studio 512 GB 放得下所有開源模型嗎?
不是全部。最大的那幾個模型,例如上兆參數的版本,就算壓縮後也超過 512 GB。實際要用的模型,最好先確認檔案大小並實測。
Mac 跑 AI 比 NVIDIA 顯卡慢很多嗎?
一個人用時產生文字的速度差不多,但讀長文件明顯比較慢,也沒有適合多人同時使用的引擎。所以單人用很好,全公司共用就建議 NVIDIA。
可以用 Mac 做模型微調嗎?
可以,MLX 也支援微調。但如果微調是主要工作,NVIDIA 的工具和資源比較完整,速度也比較快。
結語:Mac 是好的個人 AI 工作站
Mac Studio 讓老闆不用機房、不用吵雜的伺服器,也能跑很大的模型,這是很實際的選擇。只是它的強項在一個人用,不在全公司共用。
如果你在想公司的 AI 該放在 Mac 還是伺服器上,可以先看看我們怎麼做 AI 系統開發,或帶著你們的人數和用途來聊。