「我們想讓 AI 真的懂我們公司,是不是要拿公司的資料去訓練一個自己的模型?」
這是導入地端 AI 時,老闆最常有的想像。聽起來很合理:自己的模型、用自己的資料訓練,一定最懂自己。但實際上,大部分公司走這條路,會花很多錢,效果卻不如預期。
我是熊董,台灣川輝科技創辦人。我帶團隊做系統導入七年,經手超過 252 個案子、橫跨 32 個以上產業,也實際調整過開源模型的行為。
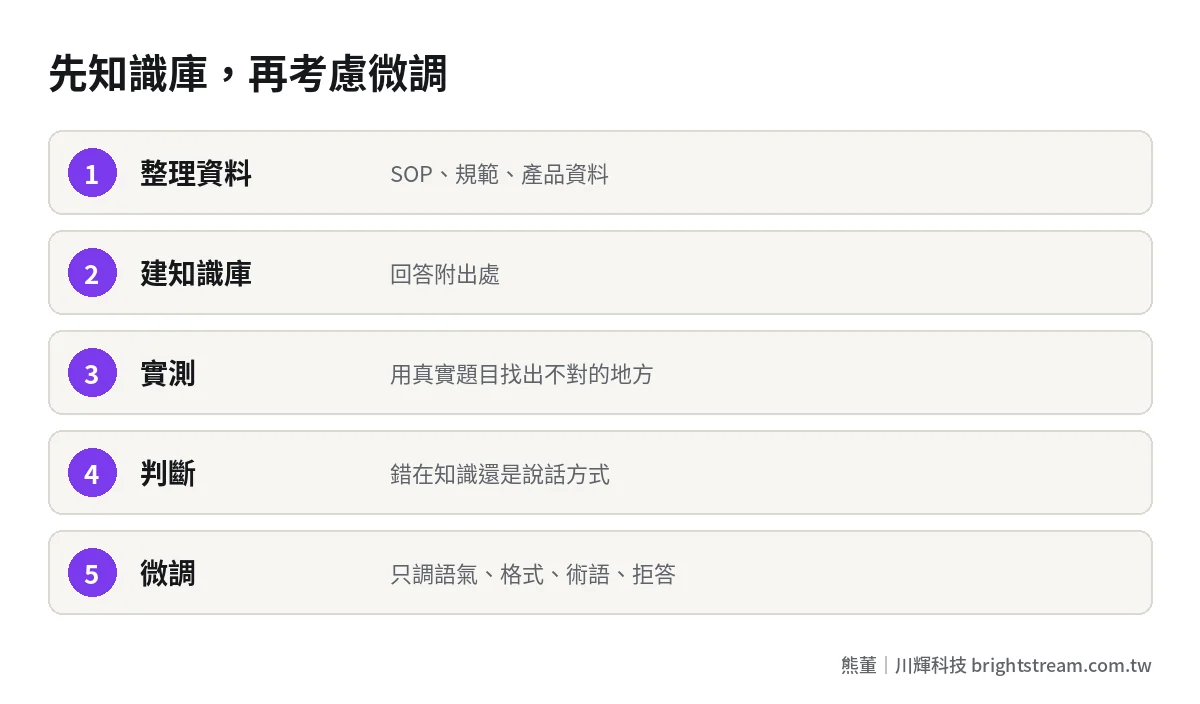
我的答案是:要讓 AI「知道」公司的事,先做知識庫;要讓 AI「說話方式」符合公司,才考慮微調。知識庫把公司資料整理成 AI 查得到的資料,資料一改就生效,還能附上出處;微調是改變模型本身的行為,適合調語氣、格式、專業術語,不適合用來記會變動的知識。
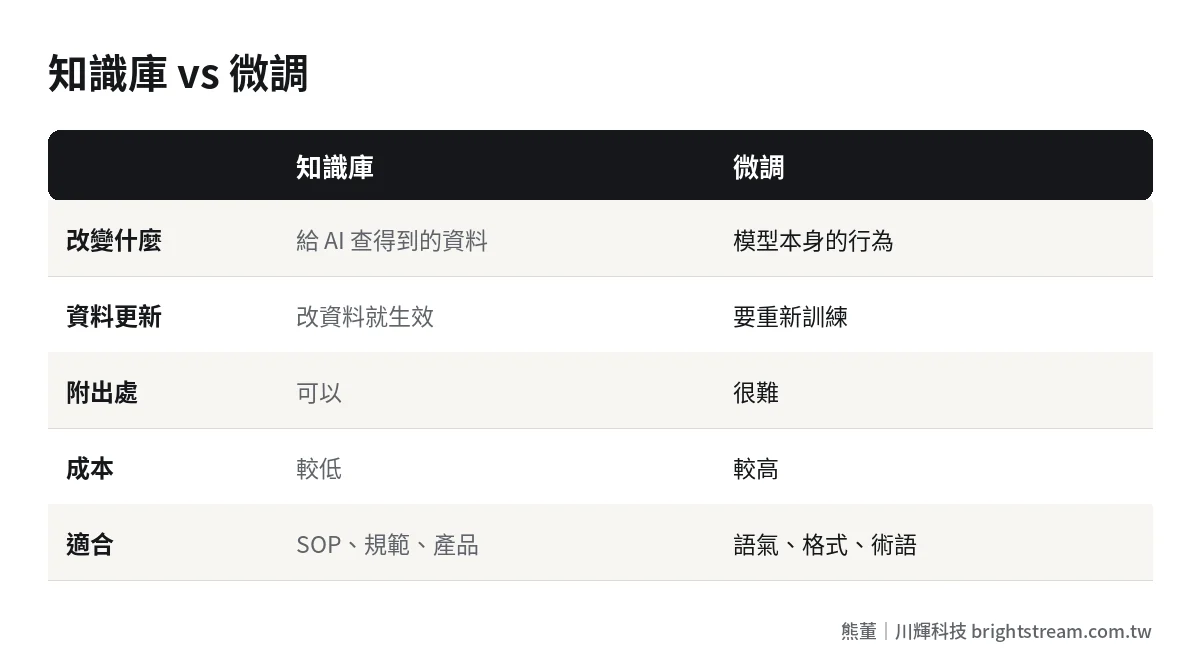
知識庫和微調差在哪?
用一個比喻來說。知識庫像是給新進員工一本整理好的手冊,他每次回答前先去翻,答案有根據,手冊更新了他就知道新的。微調則像是送他去受訓三個月,改變的是他說話和做事的習慣。
| 比較 | 知識庫(RAG) | 微調 |
|---|---|---|
| 改變什麼 | 給 AI 查得到的資料 | 改變模型本身的行為 |
| 資料更新 | 改資料就生效 | 要重新訓練 |
| 能附出處嗎 | 可以,回答附上來源段落 | 很難 |
| 成本 | 較低,主要是整理資料 | 較高,要訓練資料和運算資源 |
| 適合 | 產品資訊、SOP、規範、報價紀錄 | 語氣、格式、術語、拒答行為 |
依 Largitdata 的建議,知識會變或需要附出處時,應該先把知識庫做好,再考慮微調。我們的經驗也一樣:大部分公司做完知識庫,就已經解決了八成的問題。
為什麼大部分公司不該先微調?
先承認一件事:微調確實能讓模型更像「你的」模型。這個直覺沒有錯。
問題在於,公司最想讓 AI 知道的東西,通常是會變的:產品價格、規格、流程、法規。用微調把這些「記」進模型裡,資料一改就要重新訓練;而且模型記住的東西沒辦法附出處,員工不知道它講的對不對。
另一個問題是資料。微調需要大量整理好的「問題配標準答案」,而大部分公司連 SOP 都還沒整理完。這種情況下先做微調,等於在地基還沒打好就蓋二樓。資料整理的問題,我在 Excel 資料亂到 AI 也救不了寫過。
什麼時候真的需要微調?
微調不是沒用,而是要用在對的地方。以下幾種情況值得考慮:
- 語氣和格式:希望 AI 的回答固定用某種格式,例如檢驗報告的固定段落、客服回覆的固定語氣。
- 專業術語:產業有大量特殊術語,模型一直用錯。
- 固定流程:某個任務每次步驟都一樣,例如把客戶來信分類成十種,微調後更穩定。
- 拒答行為:模型對某些正常的專業問題過度拒答,需要調整。
前三種用一般的微調就可以。第四種比較特殊,後面另外說明。
微調有哪些方法?要多少硬體?
微調的方法很多,老闆不用懂細節,知道幾個名詞就好:
| 方法 | 是什麼 | 硬體需求 |
|---|---|---|
| LoRA/QLoRA | 只訓練少量額外的參數,不動原本的模型;QLoRA 再把原模型壓縮省記憶體 | 最省,NVIDIA 官方說 DGX Spark 可以微調到 700 億參數的模型 |
| 全參數微調 | 模型的所有參數都重新訓練 | 最貴,70 億參數以上通常要資料中心等級的卡 |
| SFT | 用「問題+標準答案」配對來訓練 | 搭配 LoRA 使用 |
| DPO | 用「好答案、壞答案」配對,教模型偏好哪一種 | 搭配 LoRA 使用 |
依 Hugging Face PEFT 的說明,LoRA 這類方法只微調少量額外參數,是企業最常用的方式。全參數微調吃多少記憶體?同一份文件舉例,一個 10 億參數的模型,光權重就要 1.86 GiB,加上訓練時的梯度與優化器狀態還要約 5.59 GB(來源)。模型越大,需求越倍數增加。
至於訓練資料要準備多少,這次查的資料都沒有給出可靠的數字,要看任務而定。我們的做法是先用幾百筆高品質的範例試,看效果再決定要不要加。
特殊用途:調整模型的拒答行為
這是開源模型一個很有用、但比較少人講的能力。
主流的雲端模型對某些主題有嚴格的使用政策。例如 Anthropic 的使用政策明文禁止情色內容(來源)。這些規定大多合理,但有時候會連正常的醫療問題也一併拒答。我們遇過的例子是醫美診所:客人問到私密處療程、身體部位的問題,模型常常直接拒答或答得很含糊,對診所的客服來說很困擾。
開源模型可以調整這類過度拒答的行為。社群裡有一種做法,技術上是找出模型內部負責「拒絕回答」的那個方向,把它移除(來源)。
但這件事有代價,要講清楚:
- 品質會下降:同一篇文章指出,移除拒答之後模型品質也跟著下降,要再用 DPO 救回來。
- 責任在自己:模型不再拒答,代表把關的責任回到使用的公司身上,要另外加上規則和紀錄。
- 授權要確認:各模型的授權對移除安全機制怎麼規定,要逐一看原文。
- 法律要確認:涉及成人內容、未成年人的部分,台灣都有法律責任,上線前一定要請律師確認;未成年人相關內容一律不做。
所以我們的做法是:只針對正常的專業需求調整拒答範圍,例如讓醫美 AI 能正常回答醫療問題,同時加上自己的規則與紀錄,而不是讓模型什麼都答。
常見問題
想讓 AI 懂公司,一定要訓練自己的模型嗎?
不用。大部分情況先做知識庫就夠,把公司的 SOP、規範、產品資料整理成 AI 查得到的資料。資料一改就生效,回答還能附出處,比微調便宜又好維護。
微調一次要多少錢?
主要看模型大小和方法。用 LoRA 微調中型模型,一台 AI 小主機或專業卡工作站就做得到;全參數微調大模型則需要資料中心等級的顯卡。最大的成本通常不是硬體,而是整理訓練資料。
微調後的模型還能更新嗎?
可以,但要重新訓練。這也是為什麼會變動的知識不適合用微調,應該放在知識庫。微調適合改穩定的行為,例如語氣、格式、術語。
開源模型可以改成不拒答嗎?
技術上可以,但會降低模型品質,而且把關責任回到自己身上。我們只建議針對正常的專業需求調整,例如醫療問題,並加上規則與紀錄;成人、未成年相關內容要先確認法律責任。
結語:先教它查資料,再改它說話方式
讓 AI 懂公司,最有效的第一步是做知識庫,不是訓練模型。等知識庫穩定了,發現語氣、格式、術語或拒答行為還不對,再用微調處理。
如果你想讓 AI 真的用得上公司的資料,可以先看看我們怎麼做 AI 系統開發,或延伸閱讀地端 AI 模型怎麼選和為什麼教員工寫 Prompt 沒用。