「我們在自己電腦上試,AI 回得很快啊。為什麼正式上線給全公司用,大家都說好慢?」
這是我們接手地端 AI 案子時,很常聽到的一句話。老闆在自己電腦上試的時候,一個人問、一個人等,當然很快。可是早上九點全公司同時打開來問,情況就完全不一樣了。
我是熊董,台灣川輝科技創辦人。我帶團隊做系統導入七年,經手超過 252 個案子、橫跨 32 個以上產業,也做過離線運作的 AI 客服,客服系統最怕的就是一次湧進很多人。
我的答案是:地端 AI 的速度要分兩種看。一個人用時,速度取決於顯卡的記憶體頻寬;很多人同時用時,速度取決於推論引擎。很多公司上線後變慢,問題不在顯卡不夠好,而在用了只適合一個人用的工具去服務全公司。
速度要看哪兩個數字?
先把兩個名詞講清楚,後面才看得懂。
每秒幾個 token:token 大約是模型處理文字的單位,一個中文字常常是一到兩個 token。每秒吐出越多 token,回答出現得越快。
第一個字要等多久:從按下送出到看到第一個字的時間。這個數字對使用感受的影響,常常比每秒幾個 token 更大。
多快才夠?依 Runpod 的說明,每秒 43 個 token 已經「比大多數人閱讀快」,第一個字在 100 毫秒內出現,在聊天介面裡幾乎感覺不到等待。換句話說,一個人用的時候,大部分顯卡都已經夠快了。真正的問題出在很多人同時用。
一個人用的時候,速度由什麼決定?
先承認一個直覺:大家都以為顯卡越「強」越快。這不算錯,但不完整。
一個人用的時候,模型每吐一個字,都要把整個模型從記憶體讀一遍。所以速度的上限,取決於顯卡的記憶體能多快把資料送出來,也就是記憶體頻寬。ComputingForGeeks 的實測也寫明:只有一個請求時,速度受記憶體頻寬限制。
下面是同一套測試條件下,不同顯卡一個人用的速度(Ollama、4 位元量化、4K 長度,單位是每秒 token 數),資料來自 ComputingForGeeks 2026 年 6 月的測試:
| 顯卡 | 80 億參數模型 | 320 億參數模型 | 700 億參數模型 |
|---|---|---|---|
| RTX 3090(24 GB) | 119 | 37 | 放不下 |
| RTX 4090(24 GB) | 148 | 43 | 放不下 |
| RTX 5090(32 GB) | 250 | 71 | 放不下 |
| L40S(48 GB) | 113 | 33 | 16 |
從這張表可以看到兩件事。第一,模型越大越慢,320 億參數的模型大概只剩 80 億的三分之一速度。第二,記憶體不夠就直接跑不了,700 億參數的模型在 24 GB、32 GB 的卡上都放不下。
為什麼放得下不等於跑得快?
這是很多人買硬體時沒注意到的地方。
有些機器記憶體很大,大模型放得下,但記憶體頻寬比較小,跑起來就慢。依 Presenc 整理的測試,gpt-oss 200 億參數模型在 RTX 5090 上每秒約 205 個 token,在記憶體更大的 DGX Spark 上只有約 49.7 個。
Mac 也有類似的情況。依 VDF 轉引 MacStories 的測試,Mac Studio M5 Ultra 跑 Qwen3.8-27B 每秒 48 個 token,RTX 5090 是 59 個,差距不大;但讀題目的速度是 1,701 對 3,031,文件越長差距越明顯。
所以挑硬體要同時看兩件事:記憶體放不放得下,頻寬夠不夠快。
很多人同時用的時候,差在推論引擎
這是整篇最重要的一段。
推論引擎就是讓模型跑起來的程式。有些引擎是為一個人用設計的,安裝簡單、上手快,很適合在自己電腦上試;有些是為正式服務設計的,能把很多人的請求排在一起處理。
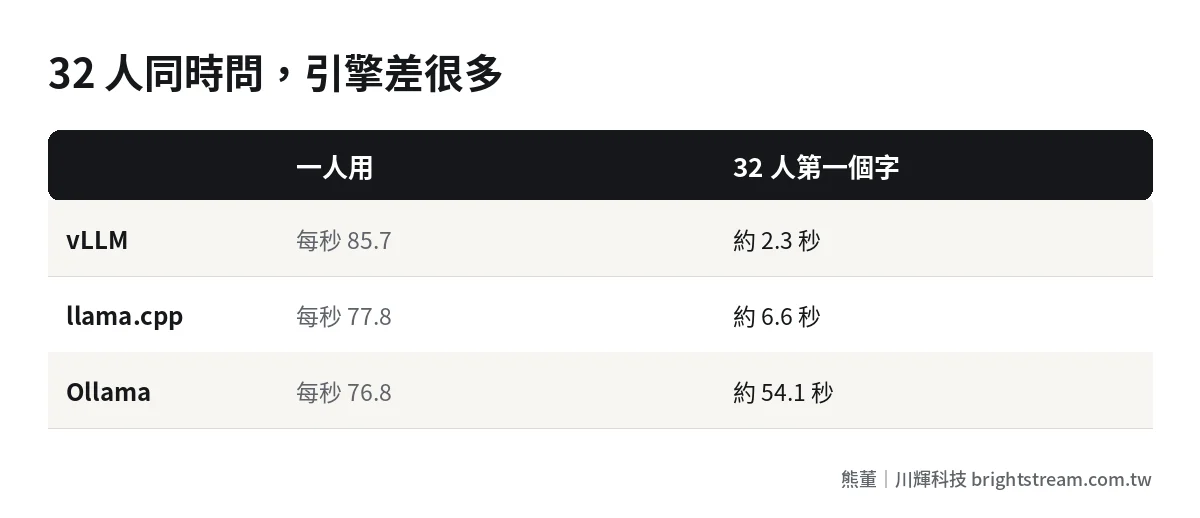
ComputingForGeeks 2026 年 10 月的實測用同一個 270 億參數模型、同一張 RTX 5090,比較三種引擎在 32 個請求同時進來時的表現:
| 引擎 | 一個人用(每秒 token) | 32 人合計(每秒 token) | 32 人時第一個字要等 |
|---|---|---|---|
| vLLM | 85.7 | 936 | 2.3 秒 |
| llama.cpp | 77.8 | 369 | 6.6 秒 |
| Ollama | 76.8 | 74 | 54.1 秒 |
一個人用的時候,三種引擎差不多快。可是 32 人同時問的時候,用 Ollama 第一個字要等將近一分鐘,換成 vLLM 只要 2 秒多。原因是那次測試裡,Ollama 對這個模型一次只處理一個請求,後面的人只能排隊。
這就是開頭那位老闆遇到的情況:在自己電腦上用 Ollama 試,很快;上線後還是用同一套,全公司一起用就塞住了。正式給多人用,一定要用 vLLM 或 SGLang 這類為多人服務設計的引擎。
還有哪些事會讓 AI 變慢?
除了顯卡和引擎,還有三件事會明顯影響速度。
文件越長越慢。 依 Presenc 的整理,Qwen3 80 億參數模型在 RTX 5090 上,4K 長度每秒約 200 個 token,32K 降到約 130,128K 只剩約 59。如果每次都把整份長文件丟給 AI,速度會掉很多。比較好的做法是先做知識庫,只把相關的段落給 AI。
MoE 模型比較快。 有些模型總參數很大,但每次只用到一部分,這種叫 MoE。同樣大小下,MoE 模型通常快二到四倍。這是選模型時可以考慮的地方。
資料中心的卡快很多。 依 Runpod 2026 年 9 月的實測,同一個 70 億參數模型、同一套引擎,一個人用的速度 B200 約 272、H200 約 195、H100 約 165,RTX 5090 約 101、RTX 4090 約 61。如果要服務很多人,資料中心等級的卡值得考慮。
上線前一定要做的壓力測試
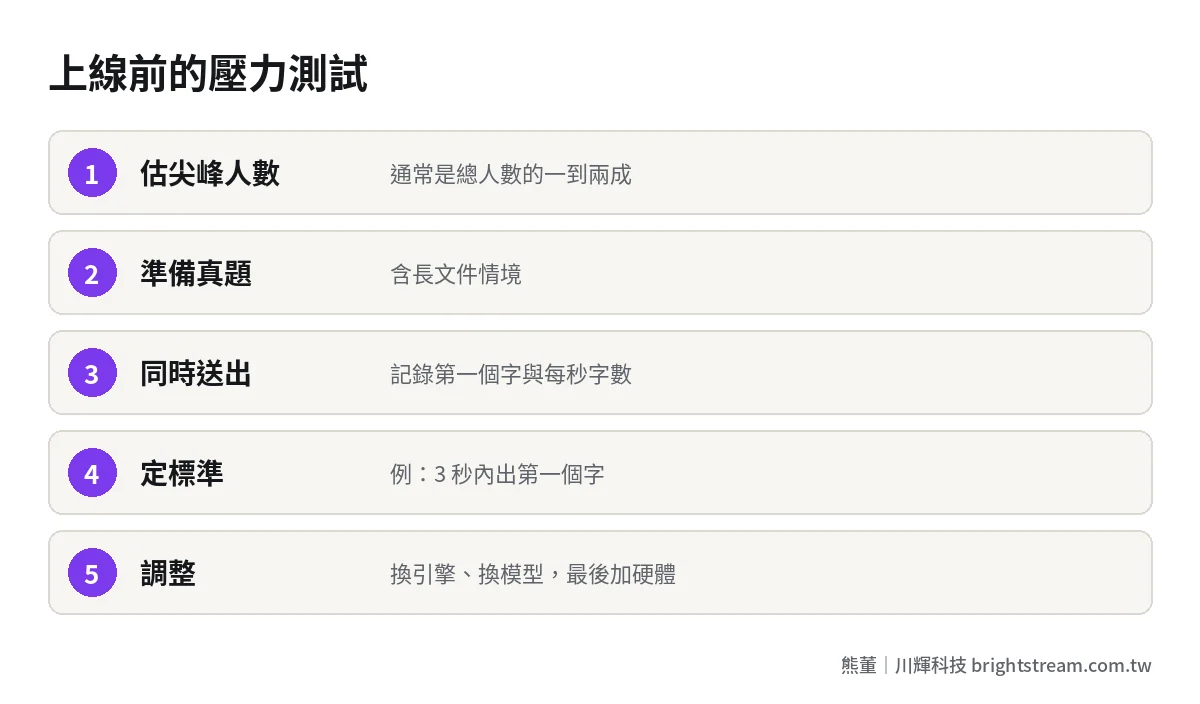
速度問題最好在買硬體之前就發現。我們的做法是上線前一定做壓力測試,步驟如下:
- 估同時使用人數:不是公司總人數,是尖峰時段同時在問的人數。通常是總人數的一到兩成。
- 準備真實的題目:用員工真的會問的問題,包含長文件的情況。
- 模擬同時送出:用工具同時送出這麼多請求,記錄第一個字要等多久、每個人每秒幾個字。
- 定合格標準:例如尖峰時段第一個字 3 秒內出現、每人每秒至少 20 個字。
- 不合格就調整:換引擎、換小一點的模型、加快取,最後才考慮加硬體。
這套測試不用花很多錢,可以先租 GPU 跑。做完之後,你就知道該買哪一級的硬體,而不是憑感覺買。硬體怎麼分級,可以看地端 AI 要買什麼硬體。
速度跟成本怎麼取捨?
最後講一個老闆常問的問題:是不是越快越好?
不一定。每秒 43 個 token 就已經比人讀得快,再快對使用者來說差別不大。與其追求極致速度,不如把錢花在讓更多人同時用得順,以及讓 AI 答得更準。很多公司 AI 用不起來,不是因為慢,而是因為答不準、資料沒整理好。這部分可以參考為什麼教員工寫 Prompt 沒用和地端 AI 模型怎麼選。
常見問題
地端 AI 每秒要幾個字才算夠用?
一個人用的話,每秒 40 個 token 左右就比大多數人閱讀快。更重要的是第一個字要等多久,最好在 1 到 3 秒內。多人使用時,要看尖峰時段每個人的速度,而不是單人測試的數字。
為什麼在自己電腦上很快,上線後變慢?
通常是因為用了為單人設計的推論引擎,例如 Ollama,多人同時問時只能排隊。正式上線要改用 vLLM 或 SGLang 這類支援多人批次處理的引擎,並在上線前做壓力測試。
多少人同時用需要升級硬體?
沒有固定數字,要看模型大小、文件長度和引擎。實測顯示一張 RTX 5090 配 vLLM,32 個請求同時進來,第一個字約 2 秒出現。建議用自己的題目做壓力測試再決定。
Mac 跑地端 AI 夠快嗎?
一個人用的速度跟高階顯卡差不多,但讀長文件比較慢,也沒有適合多人同時使用的引擎。適合個人或小團隊,不適合全公司共用。
結語:一個人快不代表全公司快
地端 AI 的速度,一個人用看記憶體頻寬,多人用看推論引擎。上線前先估尖峰人數、做壓力測試,才不會買錯硬體、用錯工具。
如果你們已經在試地端 AI,卻擔心上線後撐不住,可以先看看我們怎麼做 AI 系統開發,或直接告訴我你們尖峰時段大概多少人。