「熊董,現在開源模型那麼多,千問、DeepSeek、Llama、Gemma,到底哪一個最好?我們要裝在公司裡面。」
這是今年老闆問我最多次的問題之一。問的人通常已經看過幾篇排行榜文章,每一篇推薦的都不一樣,越看越亂。
我是熊董,台灣川輝科技創辦人。我帶團隊做系統導入七年,經手超過 252 個案子、橫跨 32 個以上產業,也做過離線運作的 AI 客服,幫一家顧問公司在他們自己的機房建過地端模型。
我的答案是:沒有「最好」的模型,只有「你能用、放得下、考得過」的模型。選型的順序是先用限制條件刪掉不能用的,再用公司自己的題目實測,最後才看速度和價格。排行榜只能當參考,不能當答案。
為什麼不能直接看排行榜選?
先講句公道話。看排行榜是很合理的直覺,你買車也會先看評比。排行榜也確實有用,它告訴你哪些模型值得放進候選名單。
問題在於,排行榜考的不是你的題目。它考的是數學、程式、英文常識,而你的員工要問的是「這個客戶上次報價打幾折」「這張檢驗報告哪一項超標」「這份合約跟我們的範本差在哪」。這些問題牽涉繁體中文、台灣用語、你們公司自己的術語,排行榜一題都沒考。
還有一個更實際的原因:很多排名靠前的模型,你根本不能用。可能是來源國不行、授權不允許、或你的硬體放不下。所以正確的順序是倒過來的,先刪,再考。
選模型之前,先確認你真的需要地端
在進入四個問題之前,還有一個更前面的問題:你的資料,能不能送到雲端?
如果可以,大部分情況下我會建議直接用雲端的 AI 服務。雲端的頂尖模型通常更聰明,不用買機器、不用找人維護,用多少付多少。對資料不敏感、用量又不大的公司來說,地端反而是花冤枉錢。
地端真正值得做的情況,是資料不能出公司:醫療院所的病歷、檢驗公司的客戶樣品數據、製造業的配方和製程參數、會計師和律師手上的客戶資料,或是合約、稽核、標案明文要求資料不能離開。這時候雲端再聰明也用不了,地端才是唯一能用 AI 的做法。
也有不少公司是兩者混合:敏感的資料走地端模型,一般的文書工作走雲端。這種做法在選型時要多考慮一件事,就是兩邊的回答風格和格式要盡量一致,員工才不會覺得在用兩套不同的系統。
確認自己真的需要地端之後,再來看下面四個問題。
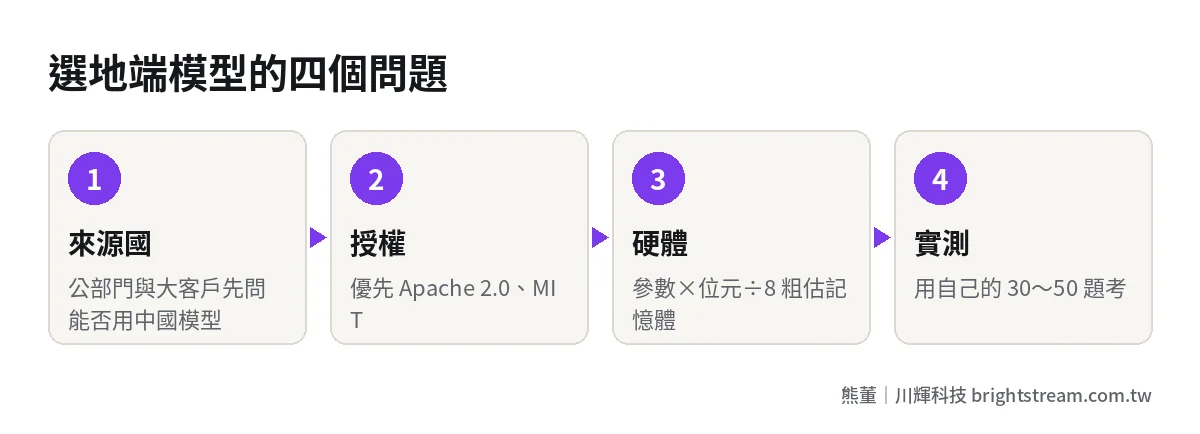
第一個問題:模型的來源國有沒有限制?
這一題要最先問,因為答案是「不行」的話,後面都不用談。
如果你的公司做政府標案、是公部門的供應商,或是大客戶的供應鏈有稽核,先確認能不能用中國廠商的模型。目前主流的大型開源模型裡,有一半以上來自中國廠商,包括阿里巴巴的千問(Qwen)、DeepSeek、月之暗面的 Kimi、智譜的 GLM、MiniMax、小米的 MiMo。
依 Largitdata 的整理,台灣政府機關不得使用 DeepSeek 的服務,連下載到本機的模型也不行。這是該文轉述的政策,實際適用範圍請以主管機關公告為準。
如果你的情況是「不能用中國模型」,候選名單就從這幾個開始:OpenAI 的 gpt-oss、Google 的 Gemma、IBM 的 Granite、法國的 Mistral,以及台灣自己的 TAIDE。
第二個問題:授權可以商用嗎?
開源不等於可以隨便用。每個模型、甚至同一個系列的不同版本,授權都不一樣。
| 授權類型 | 代表模型 | 對企業的意思 |
|---|---|---|
| Apache 2.0、MIT | gpt-oss、Gemma 4、Qwen3.8-27B、DeepSeek、Phi、Granite | 商用最沒有負擔,優先選 |
| 有營收或使用者門檻 | Llama(月活躍 7 億以上要另約)、MiniMax(營收門檻)、部分大型千問版本 | 中小企業通常碰不到門檻,但要留紀錄 |
| 要標示「Built with」 | MiniMax、Meta Muse Spark Open | 產品上要掛標示,對外服務要注意 |
| 非商用 | Cohere Command A | 只能內部研究,不能拿來做生意 |
| 營收超過一定金額不得商用 | Liquid AI 的 LFM | 公司長大後會卡住 |
以上整理自 ComputingForGeeks 的模型比較表。授權會改版,上線前一定要看該版本的模型卡原文,並把授權寫進交付文件,未來稽核或客戶問起才拿得出來。
第三個問題:你的硬體放得下嗎?
這一題決定你要花多少錢買機器。粗估模型本身要多少記憶體,有一個簡單算法:
參數量 × 每個參數用幾個位元 ÷ 8 = 需要的 GB 數
Hugging Face 的說明給了一個例子:8B(80 億參數)的模型,用 16 位元存放約 16 GB,壓縮到 4 位元約 4 到 5 GB。這個「壓縮」叫量化,用一點點準確度換大量的記憶體。
但這只算到模型本身。很多人同時用、文件很長的時候,還要再多留空間。所以這一題的正確做法是:先粗估,再用真實的使用情況做壓力測試,不要算完就下單。
還有一個常見的誤會。有些模型標示「總共 1 兆參數、每次只用 300 億」,這種叫 MoE(專家混合)架構。它跑起來比較快,但記憶體要照總參數算,不是照每次用到的那部分算。
硬體怎麼挑、多少錢,我在這個系列的下一篇「地端 AI 要買什麼硬體」會整理成完整的表。
第四個問題:用你自己的題目考過了嗎?
前三個問題刪完,通常剩下三到五個候選。這時候才開始考試,而且考的是你自己的題目。
做法很簡單:
- 出題:從員工真的會問的問題裡挑 30 到 50 題。要包含繁體中文、台灣用語、你們公司的術語和產品名稱。
- 準備標準答案:請最懂的同事寫出他認為對的答案,或至少列出答案要包含哪些重點。
- 同條件比:2 到 3 個候選模型,用同樣的題目、同樣的知識庫、同樣的設定跑一遍。
- 找一個天花板:用假資料拿雲端最強的模型跑一次,知道「最好能到哪裡」。
- 看三件事:答對幾題、有沒有亂編、有沒有冒出簡體字或大陸用語。
最後一點很重要。依 NSS 的部署經驗整理,有些模型會吐出簡體字或大陸用語。對台灣的客戶和員工來說,這不只是小瑕疵,而是會讓人覺得這個系統「不是給我們用的」。
七種情境,先試哪幾個?
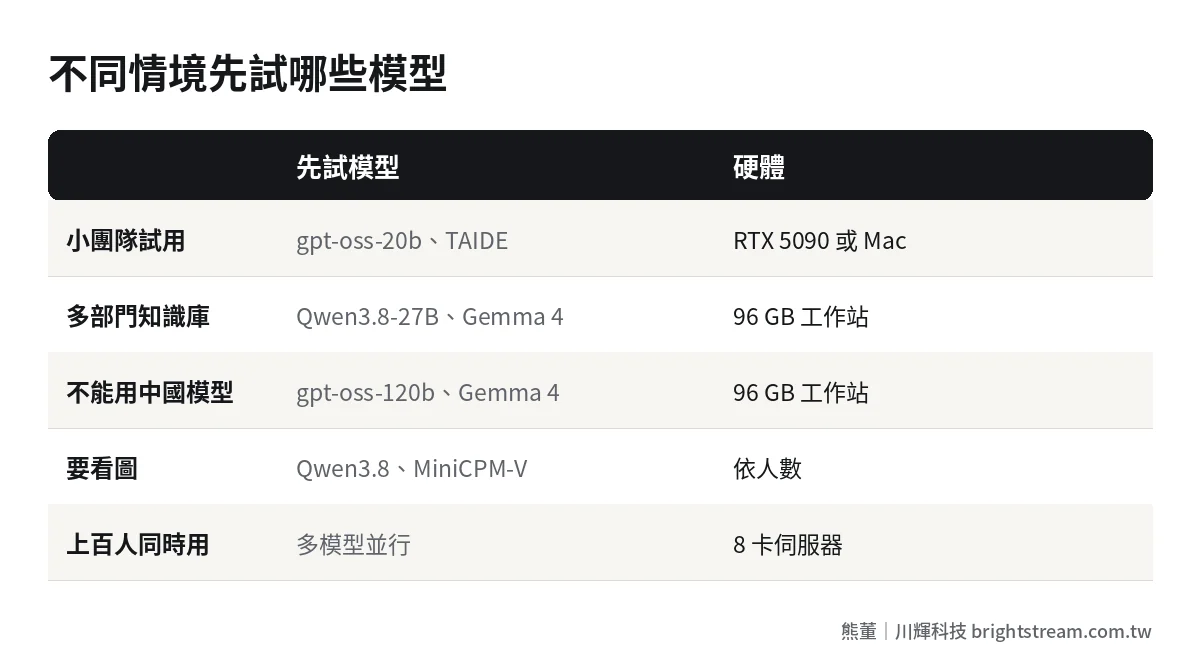
刪完、考完之前,你總要有個起點。下面是我們依常見情境整理的「先試名單」,注意是先試,不是結論。
| 情境 | 先試的模型 |
|---|---|
| 老闆或 1 到 5 人小團隊,先試文件問答 | gpt-oss-20b、Gemma 4 12B、TAIDE 12B |
| 20 到 80 人、多部門用公司知識庫 | Qwen3.8-27B、Gemma 4 31B |
| 醫療、檢驗要看圖(報告照片、表單) | Qwen3.8-27B、MiniCPM-V、Muse Glimmer 30B |
| 政府、公部門、大客戶供應鏈,不能用中國模型 | gpt-oss-120b、Gemma 4 31B、TAIDE 12B |
| 要接近雲端強度(推理、程式),但人少 | gpt-oss-120b、DeepSeek V4-Flash |
| 繁體中文公文、法規、內部文件 | TAIDE 12B、Qwen3.8-27B、Gemma 4 31B |
| 上百人同時用、多用途 | 上述任一,搭配資料中心等級的伺服器 |
模型名稱與大小整理自 Sysart 等來源,各家每幾個月就有新版,選的時候以當下的版本為準。
老闆最常選錯的三種情況
這三種情況我們在評估時常常遇到,每一種背後都有很合理的想法,只是方向偏了。
第一種:選了最大的模型,結果沒人用得起。 有老闆看到某個模型分數最高,就想直接上。但最大的模型往往要好幾張資料中心等級的顯卡,光硬體就是幾百萬起跳,回答又比較慢。員工問一題要等十幾秒,用兩天就不想用了。其實大部分公司日常的查資料、摘要、寫草稿,中型模型就夠用。
第二種:只看英文評測,上線後才發現中文不行。 很多評比是用英文題目考的。換成繁體中文、加上台灣用語之後,同一個模型的表現可能差很多。我們實測時就遇過,英文題目答得很漂亮,中文題目卻冒出一堆簡體字。這種事一定要在買硬體之前發現。
第三種:沒查授權,做到一半才發現不能商用。 有些模型下載很方便,看起來就是免費的,但授權寫明了非商用,或營收超過一定金額就要另外談。小公司一開始碰不到門檻,等到生意做起來、客戶開始稽核,才發現整套系統建在一個不能用的模型上,那時候換的成本非常高。
這三種情況的共同點是:都跳過了前面的刪去步驟,直接從「哪個最強」開始想。
選型的結果要寫成什麼?
選型不是口頭說說就好。我們每次做完選型,都會交給客戶一份簡單的紀錄,內容包括:
| 項目 | 要寫什麼 |
|---|---|
| 候選模型與版本 | 名稱、版本號、下載來源 |
| 授權 | 授權名稱、是否可商用、有沒有門檻或標示要求 |
| 來源國 | 開發者所在國家,是否符合客戶或標案要求 |
| 硬體需求 | 量化方式、預估記憶體、實測同時使用人數 |
| 實測結果 | 題目數、答對率、亂編次數、簡體字或用語問題 |
| 選定理由 | 為什麼選這個,不選其他的 |
這份紀錄有兩個用處。一是未來模型要換版時,有一套相同的題目和標準可以比較;二是客戶被稽核、或被大客戶要求說明 AI 用了什麼模型時,拿得出來。很多老闆覺得這是多餘的文書作業,但等到真的被問的那一天,就會知道它的價值。
選完模型之後,真正決定成敗的是什麼?
很多老闆以為選對模型就成功了一半。我的經驗是,模型大概只佔三成。
另外七成是兩件事。第一是知識庫:你的 SOP、規範、報價紀錄整理得好不好,AI 才查得到、答得對。這部分我在公司資料丟給 AI 安全嗎和 Excel 資料亂到 AI 也救不了兩篇講過。第二是接進工作流程:AI 要接在員工每天用的系統和 LINE 裡,不是另外開一個網頁要大家記得去問。
所以選型的目的,不是找到世界最強的模型,而是找到一個夠用、合法、穩定、你的機器跑得動的模型,然後把力氣花在讓它真的被用起來。
常見問題
地端 AI 一定要用最大的模型才會好用嗎?
不用。中小企業最常用的是 200 億到 300 億參數左右的模型,一台工作站就跑得動。模型越大越貴、越慢,先用中型模型加上整理好的知識庫,通常比單用大模型更划算。
千問和 DeepSeek 可以用嗎?
技術上可以,授權也大多寬鬆。但如果你做政府標案、是公部門供應商,或大客戶有稽核,先確認能不能用中國廠商的模型。不確定的話,選 gpt-oss、Gemma 或 TAIDE 比較保險。
開源模型的繁體中文能力夠嗎?
大多數主流模型都能讀寫繁體中文,但有些會混入簡體字或大陸用語。一定要用自己的繁中題目實測。對公文、法規類的工作,可以優先試台灣的 TAIDE。
模型選好之後,多久要換一次?
開源模型大約每三到六個月就有新版。不用每次都換,但維護期間應該定期用同一套題目考新版本,比舊的好才換,這樣才不會越用越落後。
結語:先刪,再考,最後才比快
選地端 AI 模型的正確順序是:來源國、授權、硬體、實測。前三題幫你刪掉不能用的,第四題才告訴你哪個最適合你。
如果你正在評估地端 AI,又不確定從哪一個情境開始,可以先看看我們怎麼做 AI 系統開發,或帶著你們最常被問的五個問題來找我聊。