「大模型都那麼聰明了,我們自己裝一個小模型,再怎麼調也比不上吧?」
這是我在談地端 AI 時最常聽到的質疑。老實說,在一般的考試題目上,這句話大致是對的。但老闆要的不是一個會考試的 AI,而是一個能把「自己公司那件事」做好的 AI。
我是熊董,台灣川輝科技創辦人。我帶團隊做系統導入七年,經手超過 252 個案子、橫跨 32 個以上產業。今年 6 月 2 日,我在台北國際會議中心參加了 NVIDIA GTC Taipei 2026 的全天實作坊「Adding New Knowledge to Large Language Models」,從早上 9 點半做到下午 5 點半。工作坊用一個完整案例,從頭示範怎麼把開源小模型調成專用模型。這篇把工作坊裡最有價值的數字拆給你看。
我的答案是:小模型不會在所有事情上贏過大模型,但在「你公司那一件事」上可以。NVIDIA 的案例裡,一個 80 億參數的模型經過微調,在不把整套規則塞進提示的情況下,分類平均準確率 77%,贏過 1,200 億參數的模型(75%)和 Claude Opus 4.6(73%)。關鍵不是模型多大,而是先量清楚要做好什麼,再一步一步只補缺的那一塊。
案例:一家要分派災情回報的組織
工作坊用的是一個虛構的人道救援組織,叫 Meridian。災區每天湧進幾百份現場回報,要有人讀完、判斷,然後派給對的小組處理。目前全靠人工。
他們要 AI 每讀一份回報,就輸出四個判斷:
| 判斷 | 內容 | 難在哪裡 |
|---|---|---|
| 類別 | 8 類,例如飲水衛生、醫療、物流 | 有 10 條優先順序規則,例如井水被汙染算衛生,但已經有人腹瀉就算醫療 |
| 緊急程度 | P1 到 P4 | 要看客觀證據,不看回報者語氣;標「緊急」但其實沒東西壞掉,就是最低級 |
| 派給哪個小組 | 15 個小組代碼 | 沒有寫成規則,只能從例子學 |
| 註記 | 疫情、交通受阻、經費、需要合作夥伴 | 提到「道路」不代表要標交通受阻,道路正常就不標 |
這個題目很像台灣公司每天在做的事:客服單要派給哪個部門、訂單異常要找誰、檢驗結果要不要通報。規則寫得出來,但人每次判斷都不太一樣。
第一步:先做考卷,再做任何訓練
很多公司導入 AI,第一步是去找資料、找模型。Meridian 的第一步是寫考卷。
他們手寫了 25 份回報,每一份都附上標準答案,而且每個答案都註明是依據哪一條規則。這份考卷在任何訓練資料產生之前就寫好了。工作坊坦白說,這份考卷改了三版才真正量到該量的東西。
我很喜歡這一步,因為它讓 AI 投資變得可以稽核:做之前多少分、做之後多少分、差在哪一條規則,都講得清楚。老闆問「這筆錢花得值不值」,有數字可以回答。
四個階段的成績
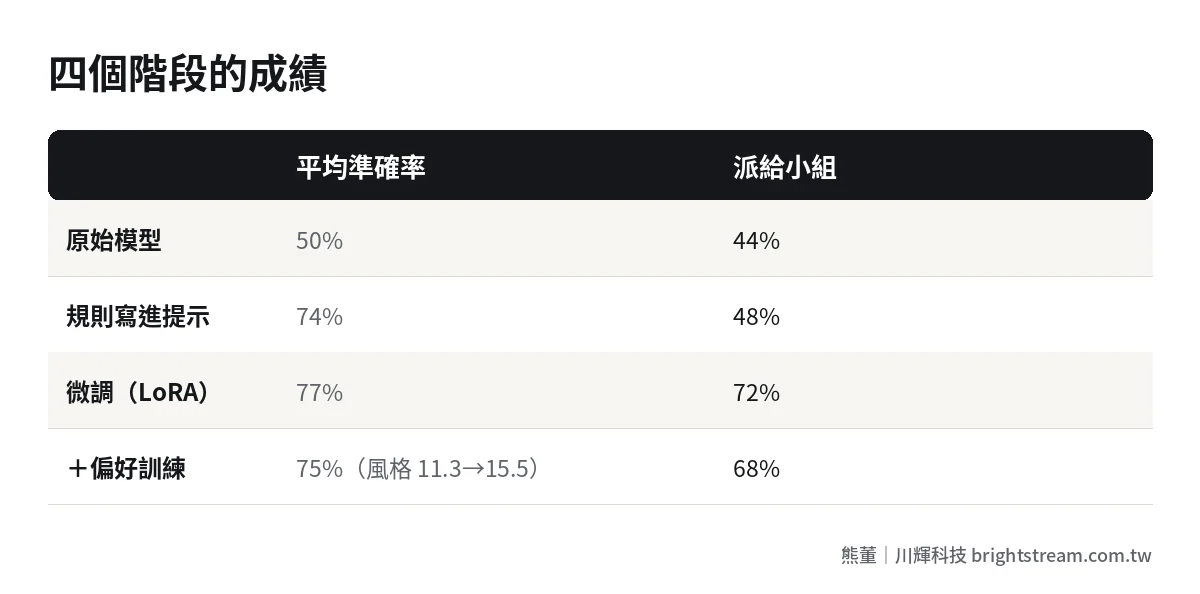
以下是同一份 25 題考卷、同一個 80 億參數模型(Mistral-NeMo-Minitron-8B-Instruct)的成績。風格是另外一份 20 分的評分表,看回答是否精簡、有沒有依據。
| 階段 | 類別 | 緊急程度 | 派給小組 | 註記 | 平均 | 風格 |
|---|---|---|---|---|---|---|
| 原始模型,只給分類清單 | 84% | 24% | 44% | 48% | 50% | 14.3 |
| 把全部規則寫進提示 | 96% | 64% | 48% | 88% | 74% | 13.7 |
| 微調(LoRA) | 84% | 68% | 72% | 84% | 77% | 11.3 |
| 微調+偏好訓練(DPO) | 84% | 76% | 68% | 72% | 75% | 15.5 |
資料來源:NVIDIA GTC Taipei 2026 實作坊「Adding New Knowledge to Large Language Models」教材。
每一個階段都在補前一個階段補不到的東西:
把規則寫進提示(50% → 74%)。 光是把規則寫清楚放進去,平均就跳了 24 個百分點。類別、註記、緊急程度都大幅進步。但「派給哪個小組」幾乎沒動(44% → 48%),因為這部分沒有寫成規則,模型讀不出來。這個沒動的地方,才是需要訓練的理由。 如果規則寫進去就達標,工作坊的結論是:直接上線,不用訓練。
微調(74% → 77%)。 平均只多 3 分,但「派給小組」從 48% 跳到 72%。而且提示少了約 2,000 個 token,每次呼叫都更便宜、更快。工作坊的說法是:微調是讓模型每次都用同樣的方式做同樣的判斷,不是教它新知識。
偏好訓練(風格 11.3 → 15.5)。 微調後的模型回答變得很囉嗦,每次寫 55 到 80 個字,還把「為什麼沒標這個、為什麼沒標那個」全部列出來。偏好訓練之後,變成 10 到 15 個字、有依據的摘要,主管一秒就能看完。準確率大致持平(77% → 75%),但這是「會被用」和「不會被用」的差別。
小模型跟頂尖雲端模型比
工作坊在投入訓練之前,也拿同一份考卷去考兩個頂尖的雲端模型:
| 模型 | 提示 | 平均準確率 |
|---|---|---|
| 80 億參數原始模型(地端) | 只給分類清單 | 50% |
| Claude Opus 4.6(雲端) | 只給分類清單 | 73% |
| 1,200 億參數老師模型(雲端) | 只給分類清單 | 75% |
| 80 億參數微調後(地端) | 只給分類清單 | 77% |
| Claude Opus 4.6(雲端) | 加上全部規則 | 81% |
| 1,200 億參數老師模型(雲端) | 加上全部規則 | 81% |
這張表要誠實讀:
- 在同樣只給分類清單的條件下,微調後的小模型贏了。 因為規則已經學進模型裡,不用每次都附上。
- 大模型附上全部規則,還是比小模型多 4 分。 代價是每次呼叫都要多送約 2,000 個 token,而且資料要送出公司。
- 大模型在需要細膩判斷的「註記」上比較強(附規則時 92% 到 96%,小模型 84%)。如果你最在意的是這種判斷,結論可能不一樣。
工作坊的結論很直接:微調小模型不是為了在排行榜上贏大模型,而是在「成本、速度、資料不能出公司」這三件事重要的時候,在自己的那件事上贏。對救援組織來說,現場回報不能送到外面,這就是決定性的理由。判斷方式很簡單:先問資料能不能出去,細節可以看開源模型還是雲端大模型。
要花多少硬體與時間?
這是老闆最關心的。工作坊的環境是兩張 NVIDIA H100:
| 步驟 | 規模 | 時間 |
|---|---|---|
| 產生訓練資料 | 2,193 筆(用大模型依標準答案寫出回報內容) | 依 API 速度而定 |
| 微調(LoRA) | 一張 H100,訓練 5 輪 | 約 23 分鐘(教學版 1 輪約 3 分鐘) |
| 偏好訓練(DPO) | 263 組比較資料,兩張 H100 | 約 5 分鐘 |
| 正式服務 | vLLM,一張卡 | 可以即時切換不同的微調版本 |
真正花時間的不是訓練,而是前面的工作:寫考卷、整理規則、產生並檢查訓練資料,以及在錯的方向上試錯。硬體的等級與價格可以看地端 AI 要買什麼硬體。
對台灣公司的意義
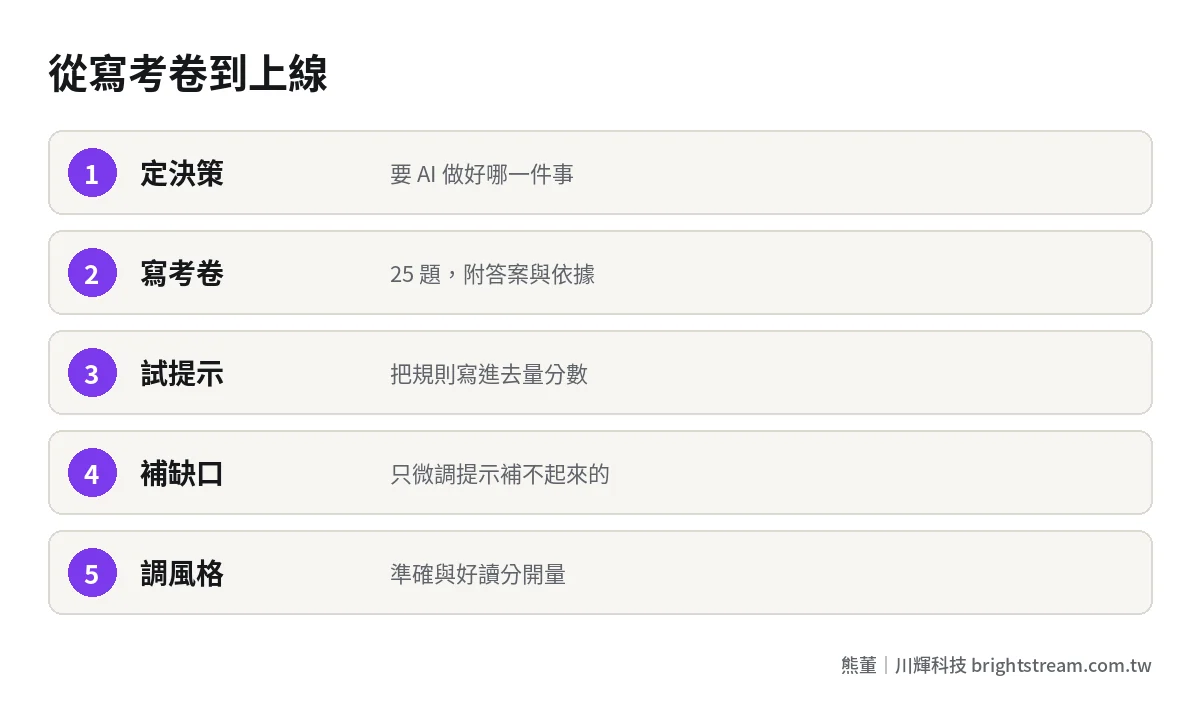
這個案例最值得帶走的,是它的順序,不是它的數字:
- 從營運決策出發。 Meridian 要的是「哪個小組先處理」。你的公司是什麼?客服單派給誰、訂單異常找誰、這張檢驗單要不要通報。
- 先寫考卷。 25 題、附標準答案和依據,比任何模型評比都有用。
- 先把規則寫進提示試試看。 很多時候到這一步就夠了,不用訓練。
- 只訓練沒動的那一塊。 規則寫進去還是做不好的地方,才是微調要補的。
- 準確率和好不好用分開量。 回答正確但沒人想讀,系統一樣沒人用。
這也是我們做 AI 導入的方式。大部分公司做到第三步就能解決大半問題;真的需要微調,我們也會先拿考卷證明值得,才建議投入。微調和知識庫各適合什麼,可以看要不要微調 AI 模型。
常見問題
小模型微調之後,真的會比 ChatGPT、Claude 好嗎?
在你公司特定的那件事上有可能,在一般能力上不會。NVIDIA 的案例中,80 億參數微調後的模型在不附規則時贏過頂尖雲端模型,但雲端模型附上完整規則後仍多 4 分。要不要微調,看的是成本、速度和資料能不能出公司。
一定要微調嗎?先把規則寫進提示不行嗎?
應該先試提示。案例中光是把規則寫進提示,平均準確率就從 50% 到 74%。如果這一步就達到你要的水準,就不用訓練;只有提示補不起來的部分,才需要微調。
微調要準備多少資料?
這個案例用了約 2,200 筆訓練資料。研究顯示,教模型固定的回答格式,大約 1,000 筆品質好的例子就夠(LIMA 研究)。重點是品質和涵蓋面,不是數量;案例裡資料多了六成,準確率只多 2 分。
訓練資料一定要用公司真實資料嗎?
不一定。這個案例的訓練資料全部是用大模型依照標準答案產生的,真實的現場回報完全沒有離開組織。這種做法適合資料敏感的公司,但產生的資料一定要抽查,老師模型錯了,學生會跟著錯。
結語:先量清楚,再只補缺的那一塊
NVIDIA 這個案例證明的不是「小模型比大模型強」,而是一套可以稽核的做法:先寫考卷,再看提示能做到哪裡,最後只訓練補不起來的那一塊。每一步都有分數,每一筆投入都說得出換到什麼。
如果你公司有一件「規則寫得出來、但每個人判斷都不一樣」的工作,可以先看看我們怎麼做 AI 系統開發,或帶著那件事來找我,我們先一起寫那份考卷。