「現在 Claude、ChatGPT、Gemini 都那麼強,我們為什麼還要自己裝開源模型?還是說,開源的其實比較好?」
這個問題沒有標準答案,但有一個很清楚的判斷方式。很多老闆把它想成「哪個比較強」的比賽,其實真正該問的是另一件事。
我是熊董,台灣川輝科技創辦人。我帶團隊做系統導入七年,經手超過 252 個案子、橫跨 32 個以上產業。我們的系統有接雲端模型的,也有做成離線運作、幫客戶把模型裝在自己機房的。
我的答案是:不是開源比較好,也不是雲端比較好,而是你的資料能不能出公司。可以出去,雲端通常更聰明、更省事;不能出去,開源地端是唯一能用 AI 的做法。很多公司最後是混著用:敏感資料走地端,一般工作走雲端。
為什麼不是比「誰比較強」?
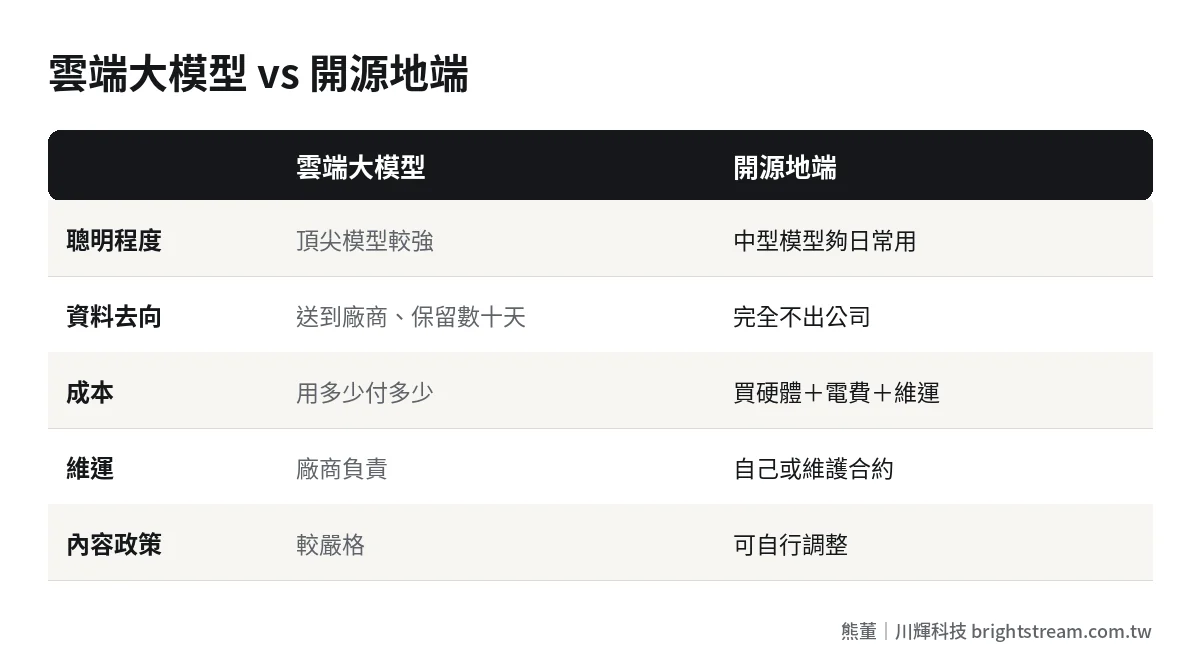
先承認一件事:單論聰明程度,雲端頂尖模型在複雜推理上通常還是比較強。這不是祕密,Hugging Face 上的整理也這樣寫。
但「比較強」只在你能用的時候才有意義。如果你是醫療院所,病歷不能送出去;如果你是檢驗公司,客戶的樣品數據有保密合約;如果你在做政府標案,對方明文要求資料不出境。這時候雲端再強也用不了。
所以第一個問題永遠是資料能不能出去,第二個問題才是哪個比較強、比較划算。
四家雲端大模型怎麼比?
下面整理 2026 年 11 月四家官方頁面公布的模型和價格。價格單位是每百萬 token 的美元,前面是輸入、後面是輸出。
| 廠商 | 旗艦模型 | 中階 | 小型 | 能裝在客戶機房嗎 |
|---|---|---|---|---|
| Anthropic | Claude Fable 5.2:8/40;Opus 5.5:4/20 | Sonnet 5.5:2/10 | Haiku 5.5:0.10/0.50 | 不行,但可以透過 AWS、Google Cloud、Microsoft Foundry 使用 |
| OpenAI | gpt-6.2-astra:8/40 | gpt-6.2-sol:2/10 | gpt-6-luna:0.10/0.50 | 不行 |
| Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.1 Flash-Lite:0.25/1.50 | 不行 | |
| xAI | grok-4.7:2/6 | 官方未列 | 官方未列 | 不行 |
| 開源模型 | gpt-oss-120b、DeepSeek、Qwen 等 | Qwen3.8-27B、Gemma 4 31B | gpt-oss-20b、Gemma 4 12B | 可以 |
Google 部分模型的價格在官方頁面上沒查到,表上就不寫。OpenAI 小型模型在模型頁和價格頁的數字不一致,以官方最新公告為準。四家都不能裝在客戶自己的機房,這一點是開源模型最大的差別。
雲端的資料到底去哪裡?
很多老闆擔心「用雲端 AI,資料會不會被拿去訓練」。這要看各家怎麼寫:
- OpenAI:官方寫明送到 API 的資料不會拿去訓練或改善模型,濫用監控的紀錄最多保留 30 天(來源)。
- Google:付費版不拿來改善產品,免費版會;濫用監控會保留提示與輸出 55 天(來源)。
- Anthropic:可以申請零資料保留,也可以指定在美國推論。
- xAI:預設保留 30 天,可以自助開零資料保留,但會停用部分功能。
這些條款對很多公司已經夠用。但「保留 30 天」「保留 55 天」,對病歷、配方、保密合約來說,就是不能接受的。這時候只能地端。公司資料交給 AI 的安全底線,我在公司資料丟給 AI 安全嗎寫得比較完整。
開源模型的優缺點
優點很明確:資料完全不出公司;可以自己選模型、自己調整;沒有按量計費,用越多越划算;不受雲端廠商改價、改政策、停服務影響。
缺點也要講清楚:要買硬體,2026 年硬體價格還在漲;要有人維運,模型更新和安全修補都要自己來;中型模型在複雜推理上通常不如雲端頂尖模型;多人同時用要另外設計。這些我在地端 AI 做不到的事逐一列過。
還有一點:雲端大廠對內容有比較嚴格的使用政策。例如 Anthropic 明文禁止情色內容,xAI 禁止用真人外貌做色情內容。這些規定大多合理,但有時候會連正常的醫療問題也拒答,例如醫美問到私密處療程。開源模型可以調整這類過度拒答的行為,這是它的另一個彈性。
怎麼混著用?
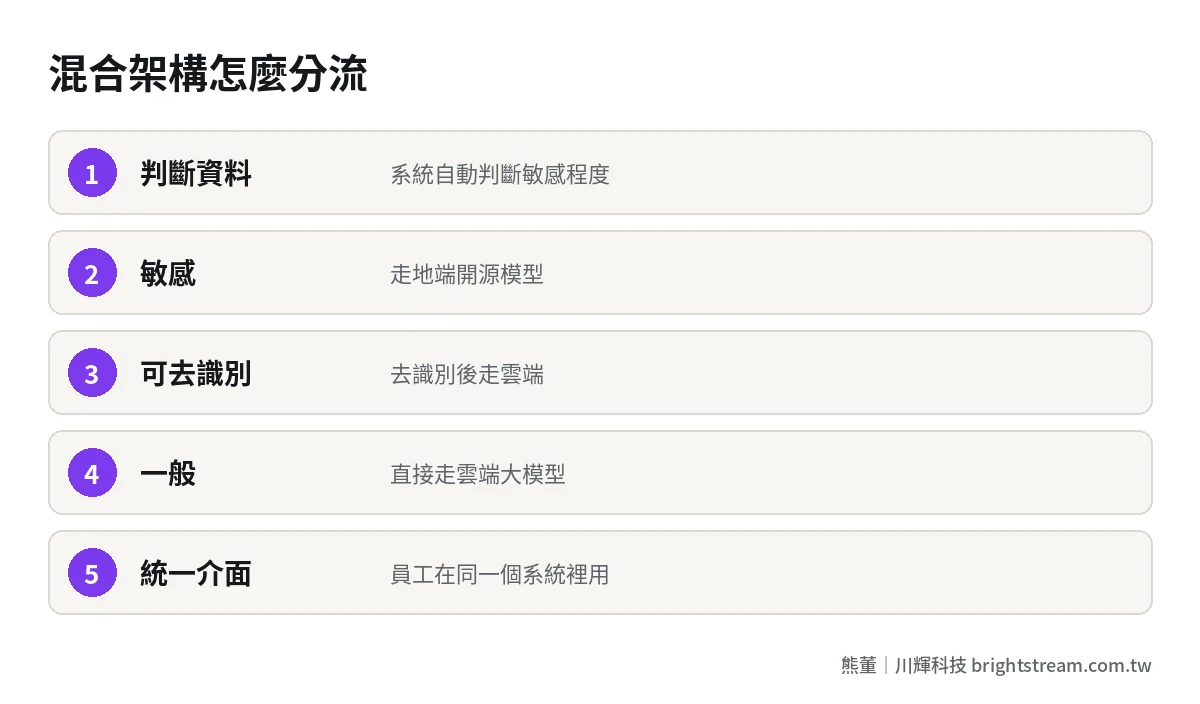
實務上,我們最常建議的是混合架構:
| 資料類型 | 走哪裡 | 例子 |
|---|---|---|
| 敏感、不能出公司 | 地端開源模型 | 病歷、檢驗數據、配方、客戶合約、財務明細 |
| 一般、可以出去 | 雲端大模型 | 行銷文案、公開資料整理、程式輔助 |
| 可以去識別化 | 先去識別,再走雲端 | 客服問題分類、匿名化的報表分析 |
混合使用要注意兩件事。第一,要有一個「分流」的機制,讓系統自動判斷哪些內容不能出去,而不是靠員工自己記得。第二,兩邊的回答風格、格式要盡量一致,員工才不會覺得在用兩套系統。
這個分流機制,就是我們做公司系統時會一起處理的部分。AI 不是另外開一個網頁,而是接在員工每天用的系統和 LINE 裡,在背後決定該送去哪個模型。現有系統怎麼加 AI,可以參考已經有 ERP,還需要 AI 嗎。
成本怎麼比?
最後講錢。雲端按量付費,用多少付多少;地端一次買硬體,加上電費和維運。
用量小的時候雲端划算,用量大的時候地端划算。有廠商試算一天要約 800 萬到 1,000 萬個 token 才回本(見 MAQ,廠商自己的假設)。大部分中小企業的用量遠低於這個數字,所以單論成本通常是雲端划算。
但成本不是唯一的考量。資料不能出去的時候,地端是唯一選項;資料可以出去的時候,再來比成本。硬體要多少錢,可以看地端 AI 要買什麼硬體;整體導入費用可以看 AI 導入要花多少錢。
常見問題
Claude、ChatGPT 可以裝在公司自己的伺服器嗎?
不行。這些雲端大模型都只能透過網路使用,最多可以選擇在特定雲端平台或特定地區推論。要完全裝在公司內部,只能用開源模型。
用雲端 AI,資料會被拿去訓練嗎?
主要廠商的企業付費 API 大多寫明不拿來訓練,但會保留一段時間做濫用監控,例如 30 天或 55 天。對大部分資料夠用,但病歷、配方、保密合約這類資料,通常連保留都不行。
開源模型會不會比雲端便宜?
用量小時通常不會。地端要買硬體、付電費、有人維運;雲端用多少付多少。地端的主要理由是資料不能出去,而不是比較省。
可以同時用雲端和地端嗎?
可以,而且很常見。敏感資料走地端,一般工作走雲端,關鍵是要有自動分流的機制,不要靠員工自己判斷。
結語:先問資料,再比模型
開源和雲端不是誰取代誰,而是看你的資料能不能出去。能出去,雲端更聰明也更省事;不能出去,地端是唯一的路;兩者都有,就混著用。
如果你不確定自己的資料該走哪一邊,可以先看看我們怎麼做 AI 系統開發,或帶著你們最敏感的那一類資料來找我聊。